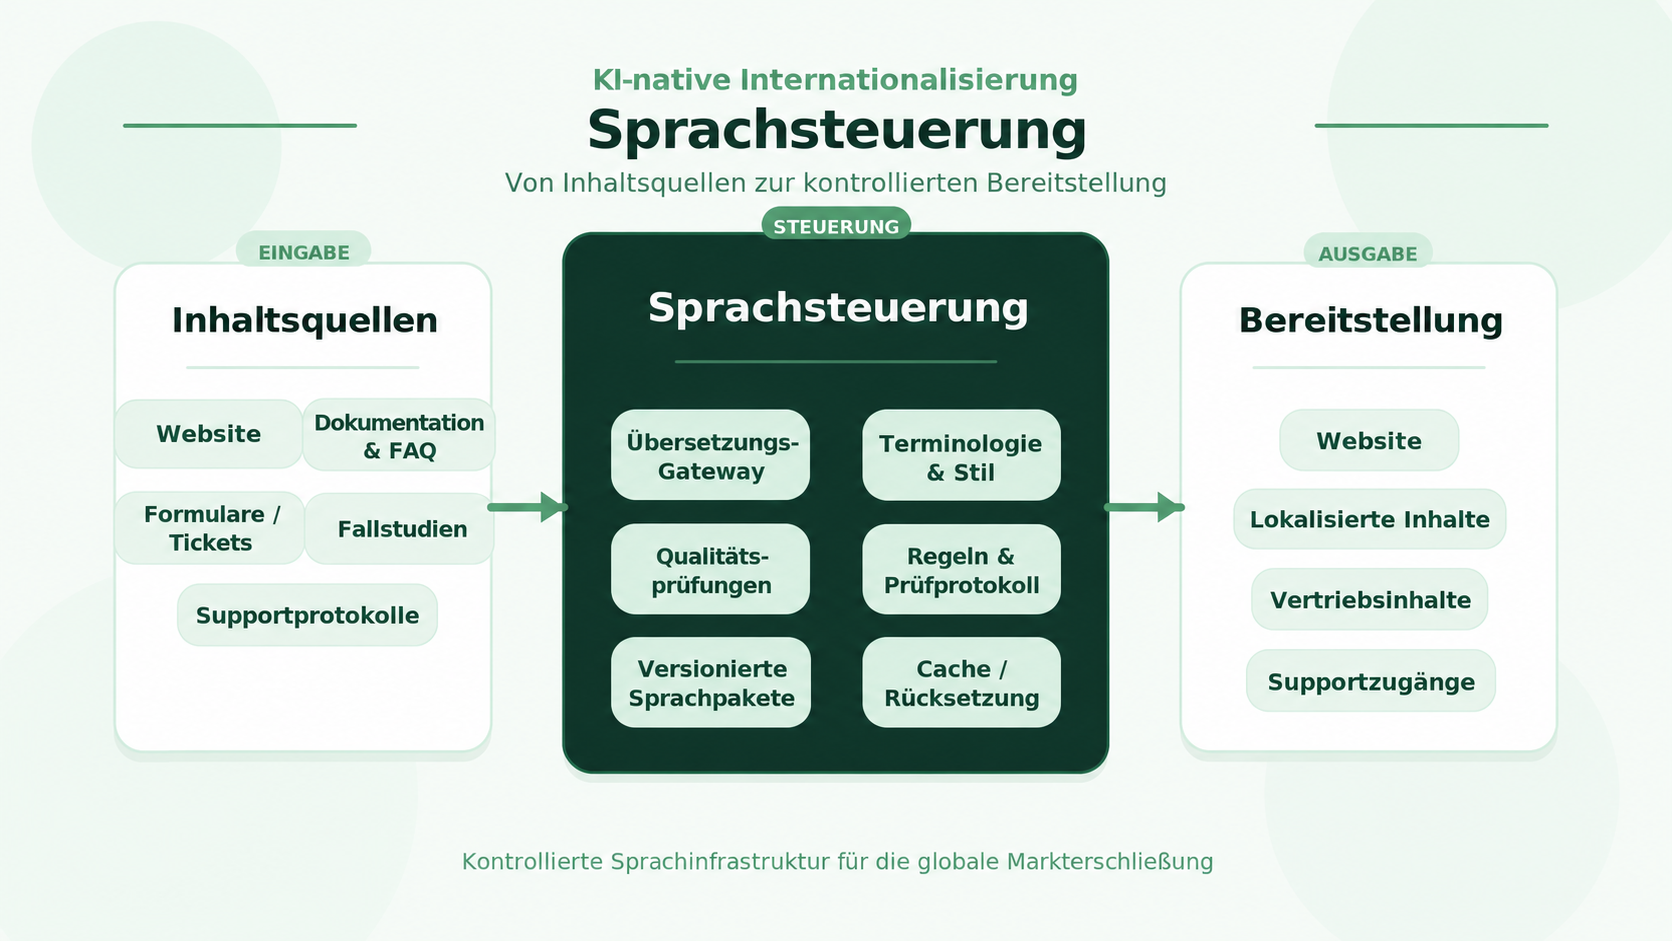
Aus der Praxis: Dieser Text entstand bei der Arbeit an marktübergreifenden Websites und Go-to-Market-Systemen für komplexe B2B-Produkte. Die folgende Architektur ist eine Checkliste für den produktiven Betrieb, die Bedeutung über Märkte hinweg stabil halten soll — kein Vergleich von Übersetzungswerkzeugen.
KI-native Internationalisierung, kurz i18n, klingt einfach, bis sie in die Nähe eines produktiven Systems kommt. Oberflächlich ist die Geschichte vertraut: schnellere Übersetzung, geringere Kosten, höhere Effizienz. Doch sobald es um reale Systeme geht, fällt dieser einfache Rahmen auseinander. Die eigentlichen Fragen tauchen fast sofort auf: Wie werden Versionen verwaltet? Was wird zwischengespeichert? Wie funktioniert eine Rücksetzung? Wie wird Terminologie durchgesetzt? Wo wird schlechte Qualität vor der Veröffentlichung gestoppt? Wo verläuft die tatsächliche Compliance-Grenze? Sobald i18n Websites, Dokumentation, FAQ, Formulare, Fallstudien oder Supportzugänge berührt, ist es kein eng umrissenes Übersetzungsthema mehr.
In unserer Arbeit an globalen Go-to-Market-Systemen betrachten wir i18n meist als Teil einer längeren Kette. Es steht neben Positionierung, Inhalten, Fallstudien, LinkedIn und direkter Kundenansprache. Zeigt die Website technische Daten, spricht der Vertrieb über Rentabilität, erzählen Fallstudien von betrieblicher Effizienz und verwenden die lokalisierten Fassungen wieder andere Begriffe, hat das Unternehmen seine Inhalte zwar übersetzt. Die Botschaft erreicht den Markt aber weiterhin nicht in stabiler Form. Darauf komme ich immer wieder zurück: Wie bleibt die Botschaft eines komplexen Produkts über Ländergrenzen hinweg konsistent, vollständig und nutzbar, statt nach Kanal und Sprache auseinanderzufallen?
Lokalisierungsprodukte mit KI-Funktionen gibt es bereits reichlich. Aus Sicht des produktiven Betriebs befinden sich die meisten jedoch weiterhin auf der Ebene der Übersetzungsproduktivität. Das ist nützlich, aber noch ein Stück von einem vollständigen KI-nativen i18n-System entfernt. Meine Frage ist einfacher und struktureller: Lässt sich die Sprachebene selbst als System behandeln? Kann sie zwischengespeichert, zurückgesetzt, geprüft, budgetiert und mit einer klaren Compliance-Grenze gesteuert werden? So gestellt interessiert mich weniger, „welches Modell wir wählen“, und wesentlich mehr: „Wo liegt die Systemgrenze, was müssen wir selbst beherrschen und was sollte außerhalb bleiben?“
Übersetzung zur Laufzeit ist nicht das System
Oft wird KI-native i18n verzerrt dargestellt, indem man sie auf die Übersetzung jeder Seite zur Laufzeit reduziert. In Demos funktioniert das. Im produktiven Betrieb stößt es schnell an Grenzen. Übersetzung bei jedem Seitenaufruf koppelt Latenz, Kosten und Verfügbarkeit unmittelbar an externe Modelldienste. Jede Störung beim Anbieter wird für den Nutzer sichtbar. Inhalte wie Preise, Garantiebedingungen, Sicherheitshinweise, Datenschutzerklärungen und Supportzusagen brauchen außerdem stabile Versionen, klare Herkunft und nachvollziehbare Historie. Sobald Formulare, Chats, Tickets oder Geräteprotokolle in dasselbe System gelangen, geht es zusätzlich um Datenverarbeitung. Compliance wird Teil der Anwendungsarchitektur. Für den produktiven Betrieb ist es deshalb hilfreicher, über eine kontrollierbare Sprachebene zu sprechen. Echtzeitgenerierung ist darin nur ein Bestandteil.
Für Websites ist es vergleichsweise sicher, standardmäßig veröffentlichte Ressourcen auszuliefern und KI inkrementelle Änderungen bearbeiten zu lassen, statt den gesamten Lesezugriff. Die stabile Basis bleibt die übliche i18n-Infrastruktur: ICU MessageFormat, CLDR, sprachabhängige Routen, versionierte Sprachpakete, CDN-Auslieferung und Caching. KI setzt darauf auf. In der Praxis übernimmt sie meist drei Arten von Arbeit: Übersetzungen für neue Inhalte erzeugen, kontrollierte Cache-Lücken füllen und bestehende Übersetzungen bewerten oder korrigieren. Solange der Standardpfad veröffentlichte Ressourcen verwendet, lassen sich Kosten und Risiken wesentlich leichter beurteilen. Das klingt vielleicht wenig radikal. Es entscheidet aber unmittelbar darüber, ob spätere Inhaltssysteme, Vertriebsmaterialien und Materialien zur Kundenansprache weiterhin ein konsistentes Sprachsystem nutzen können.
Qualität braucht Prüfstellen vor der Veröffentlichung
Auch Qualitätskontrolle wird leicht unterschätzt. In vielen traditionellen Übersetzungsabläufen gibt es menschliche Prüfung, aber sie liegt zu weit hinten und skaliert schlecht. Erhöht KI-native i18n nur die Geschwindigkeit der Generierung und lässt die Qualitätskontrolle unverändert, produziert das System lediglich schneller Fehler. Teams brauchen in der Praxis mehrere Prüfstellen vor der Veröffentlichung. Eine regelbasierte Prüfung kontrolliert Platzhalter, HTML-Tags, Zahlen, Einheiten, Links und ICU-Muster. Eine Terminologie- und Stilprüfung sorgt dafür, dass das Modell Markenbegriffe, Produktbegriffe und rechtlich sensible Formulierungen nicht frei umschreibt. Eine risikobasierte Prüfung entscheidet, welche Seiten zwingend von Menschen geprüft werden, wo nach der KI-Generierung Stichproben ausreichen und was stärker automatisiert ablaufen darf. Entscheidend ist nicht allein, dass eine Bewertung existiert. Entscheidend ist, welcher Wert eine Veröffentlichung verhindert und welche Seitenkategorien niemals automatisch freigegeben werden.
Kontext muss mit der Anfrage mitreisen
Kontext ist ebenso wichtig. Viele Übersetzungsfehler entstehen durch schwache Eingaben. Erhält ein Modell nur einen Satz, kann es nur raten. Im produktiven Betrieb müssen gewöhnlich mehrere Kontextarten mitgeliefert werden: Seitenkontext, Strukturkontext, Materialkontext und Risikokontext. Bei Industrieprodukten ist das besonders wichtig, weil derselbe Begriff unterschiedliche Erwartungen transportieren kann — auf einer Produktseite, in einer Fallstudie, im Händlerhandbuch oder in einem Supportdokument. Fehlt Kontext, fällt KI auf das Verhalten eines allgemeinen Übersetzers zurück. Mit zunehmendem Kontext verhält sie sich eher wie ein Bestandteil der Sprachebene.
Kosten werden erst greifbar, wenn man sie budgetieren kann
Auch über Kosten wird häufig zu vage gesprochen. Für Websites sind Umfang der Inhaltsänderungen, Cache-Trefferquote, Veröffentlichungshäufigkeit der Sprachpakete und der Anteil der Zugriffe, die noch externe Modellaufrufe auslösen, die nützlicheren Kennzahlen. Die meisten Übersetzungsdienste rechnen nach Zeichen, Ein- und Ausgabevolumen oder Zielsprachen ab. Das sinnvollere technische Ziel ist deshalb, unnötige Aufrufe zu vermeiden. Einige Maßnahmen helfen meist sofort: auf Segmentebene statt auf Seitenebene cachen; Quelltext-Hash, Sprachvariante, Terminologieversion, Stilversion und Modellprofil in den Cache-Schlüssel aufnehmen; Übersetzungsaufträge von Seitenzugriffen entkoppeln, sodass neue Inhalte eine Warteschlange durchlaufen statt den Hauptanfragepfad; und bei Ausfällen externer Dienste auf die letzte veröffentlichte Version zurückfallen. Stehen diese Bausteine, lassen sich Kosten budgetieren statt erraten.
Compliance gehört in die Architektur
Compliance ist ein weiteres Thema, das selten davon profitiert, aufgeschoben zu werden. Berührt das System personenbezogene Daten, Kontaktdaten, Supporttickets, Chatprotokolle oder Inhalte, die Nutzern, Geräten oder Bestellungen zugeordnet werden können, wird die Sprachebene zu einer Datenverarbeitungsebene. Dann braucht sie eine Ebene verbindlicher Regeln. Manche Inhalte dürfen zu einem Modell im Ausland, andere erfordern regionale Verarbeitung. Manche müssen zuerst geschwärzt werden, andere erlauben nur kontrollierte Änderungen innerhalb einer festen Vorlage, wieder andere müssen standardmäßig in der Region bleiben. Diese Entscheidungen lassen sich viel leichter handhaben, wenn sie in Anfrageparameter und Systemregeln übersetzt werden. Viel schwieriger wird es, wenn sie davon abhängen, wer an diesem Tag gerade eine Seite veröffentlicht.
Mit einer Steuerungsebene anfangen
Vor diesem Hintergrund erscheint mir der technische Weg nicht besonders exotisch. Ich würde normalerweise mit einer ausgereiften i18n-Basis sowie vorhandenen TMS-, maschinellen Übersetzungs- und LLM-Diensten beginnen und darüber eine schlanke Steuerungsebene legen. Sie muss am ersten Tag nicht wie eine vollständige Plattform aussehen. Eine erste Version kann klein bleiben: ein Übersetzungs-Gateway vor externen Diensten, Cache auf Segmentebene und versionierte Sprachpakete, Qualitätsprüfungen, eine Terminologie- und Stilebene, ein Prüfprotokoll und minimale Verarbeitungsregeln. Sind diese Teile vorhanden, verwendet das Team nicht mehr bloß Übersetzungswerkzeuge. Es beginnt, eine echte eigene Fähigkeit zur Sprachsteuerung aufzubauen.
Zerlegt man diese Ebene weiter, bleibt die Zahl der Schnittstellen meist überschaubar. Ein Übersetzungsendpunkt verarbeitet Einzel- und Stapelanfragen samt Kontext-, Terminologie-, Stil- und Risikodaten. Ein Veröffentlichungsendpunkt erstellt und liefert Sprachpakete nach Version aus. Ein Qualitätsendpunkt führt Prüfungen aus, blockiert unsichere Ergebnisse und nimmt Rückmeldungen aus menschlicher Prüfung an. Ein Regelendpunkt bestimmt, was externe Modelle nutzen darf und was bei festen Vorlagen oder regionalen Verarbeitungspfaden bleiben muss. Ohne diese Zugänge zerfallen Systeme leicht in lose Werkzeugsammlungen, deren Wartungsaufwand schnell steigt.
In Phasen einführen
Es gibt außerdem keinen Grund, alles in einen einzigen Veröffentlichungszyklus zu pressen. Eine erste Phase kann sich auf einen kleinen Machbarkeitsnachweis mit drei bis sechs Kernsprachen beschränken. Geprüft werden vor allem Terminologiekontrolle, versionierte Veröffentlichung, menschliche Freigabe und Rücksetzung. In Phase zwei können Übersetzungs-Gateway, Cache, Prüfprotokoll und Risikoklassifizierung den hybriden Produktivbetrieb ermöglichen. Eine dritte Phase kann warten, bis die Größenordnung sie wirklich rechtfertigt: interne Redaktionswerkzeuge, Anbieterverwaltung, Qualitätsdashboards oder multimodale Verarbeitungsketten. Eine vollständige Plattform lohnt sich erst, wenn Inhaltsmenge, Sprachzahl, Compliance-Druck und Abhängigkeitsrisiko von Anbietern gemeinsam steigen.
Unterschiedliche Inhalte brauchen unterschiedliche Regeln
Eine weitere Grenze sollte sichtbar bleiben. Bei KI-nativer i18n geht es letztlich darum, wie Modelle in ein begrenztes System eingebunden werden. Manche Inhaltsarten vertragen starke Automatisierung, andere nicht. Blogbeiträge, Nachrichten und Kampagnenseiten erlauben gewöhnlich einen hohen Automatisierungsgrad. Produktseiten, FAQ und Fallstudien benötigen häufig einen teilautomatisierten Weg. Preise, Sicherheitstexte, Rechtstexte, Garantiebedingungen, Datenschutzhinweise und Supportzusagen brauchen meist gründliche Prüfung und festgeschriebene Versionen. Die Aufgabe des Systems ist es, diese Ebenen zu unterscheiden und unterschiedlich zu behandeln. Gelingt das, kann i18n Terminologie und Ausdruck mit Positionierung, Inhalten und Kundenansprache teilen. Gelingt es nicht, wird Lokalisierung zur mehrsprachigen Vervielfältigung ohne Zusammenhalt.
Worauf ich weiter achte
Meine Schwerpunkte bleiben ziemlich konstant: Stabilität im Betrieb, verbindliche Qualitätsprüfungen, vollständiger Kontext, Kostenkontrolle und nachvollziehbare Compliance-Grenzen. Solange diese Bedingungen nicht systematisiert sind, sieht KI-native i18n für mich weiterhin wie ein Übersetzungsablauf mit aufgesetzter KI aus. Sobald diese Bedingungen ins System selbst wandern, wird auch eine Infrastruktur auf Basis externer Plattformen und Modelle deutlich substanzieller. Für ein Unternehmen wie Intelliexport.ai reicht das über Übersetzung hinaus. Es entscheidet mit darüber, ob ein komplexes Produkt über Märkte hinweg klar erklärt, konsistent durch den Kaufprozess geführt und gut genug verstanden werden kann, um gekauft zu werden.